Chất lượng của một nghiên cứu trắc lượng thư mục được quyết định ngay từ khâu dữ liệu. Bản đồ đẹp đến đâu cũng vô nghĩa nếu bộ dữ liệu bỏ sót tài liệu quan trọng, lẫn nhiều bản ghi không liên quan hoặc chứa hàng trăm bản ghi trùng. Bài viết này hướng dẫn cách thu thập và làm sạch dữ liệu từ Scopus và Web of Science một cách bài bản.
Chọn cơ sở dữ liệu
Scopus và Web of Science Core Collection là hai nguồn phổ biến nhất vì có siêu dữ liệu đầy đủ, bao gồm danh mục tài liệu tham khảo. Scopus thường bao phủ nhiều tạp chí hơn, trong khi Web of Science có lịch sử dữ liệu dài và được nhiều hội đồng đánh giá sử dụng. Các nguồn mở như OpenAlex, Dimensions hay PubMed (cho y sinh) cũng ngày càng được dùng để bổ sung.
Lựa chọn nên dựa trên câu hỏi nghiên cứu và quyền truy cập của bạn. Dùng một nguồn giúp xử lý đơn giản; gộp nhiều nguồn tăng độ bao phủ nhưng đòi hỏi làm sạch kỹ hơn. Dù chọn cách nào, hãy giải thích lý do trong phần Phương pháp.
Xây dựng chuỗi truy vấn (search string)
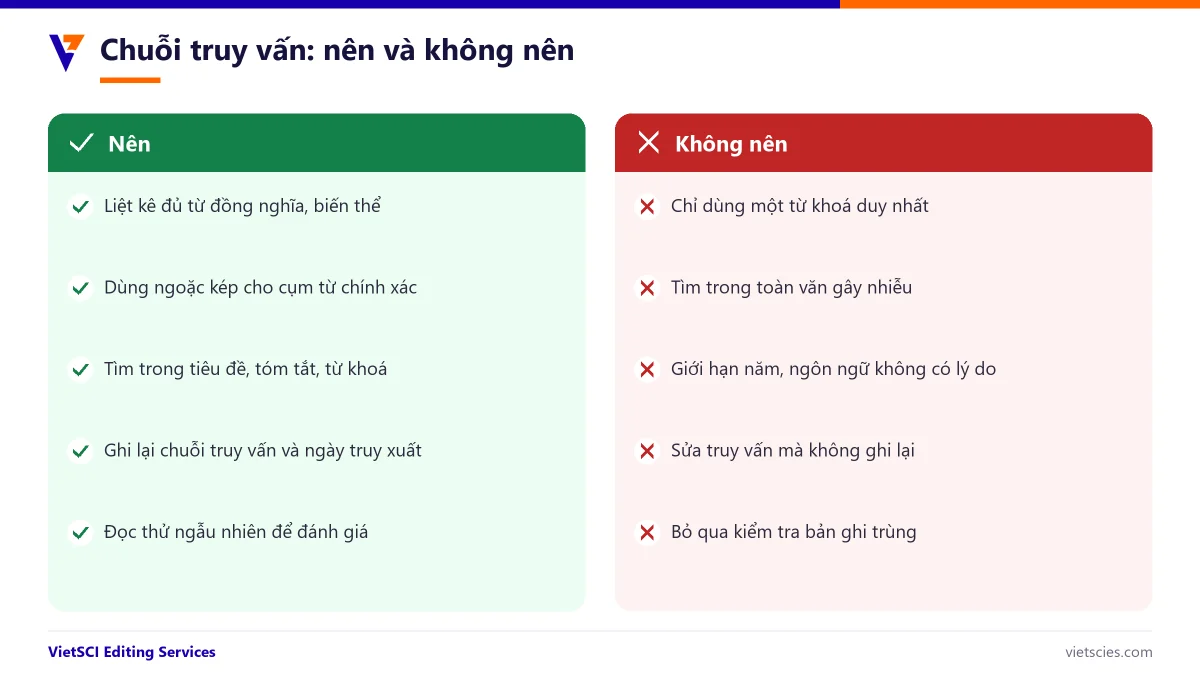
Chuỗi truy vấn tốt cần cân bằng giữa độ nhạy (không bỏ sót) và độ đặc hiệu (không lẫn tài liệu ngoài phạm vi). Các nguyên tắc chính:
- Liệt kê đầy đủ từ đồng nghĩa và biến thể, nối bằng toán tử
OR; nối các khái niệm khác nhau bằngAND. - Dùng dấu ngoặc kép cho cụm từ chính xác và ký tự đại diện (ví dụ
educat*) cho các biến thể từ. - Tìm trong tiêu đề, tóm tắt và từ khoá - trên Scopus là trường
TITLE-ABS-KEY, trên Web of Science là trường chủ đềTS. - Giới hạn năm, loại tài liệu, ngôn ngữ nếu có lý do rõ ràng.
Ví dụ minh hoạ trên Scopus: TITLE-ABS-KEY("digital transformation" AND (SME* OR "small and medium enterprise*")) AND PUBYEAR > 2014. Sau khi chạy, hãy đọc thử ngẫu nhiên vài chục kết quả để đánh giá mức độ phù hợp và điều chỉnh. Lưu lại phiên bản cuối và ngày truy xuất, vì cơ sở dữ liệu thay đổi liên tục.
Xuất dữ liệu đúng cách
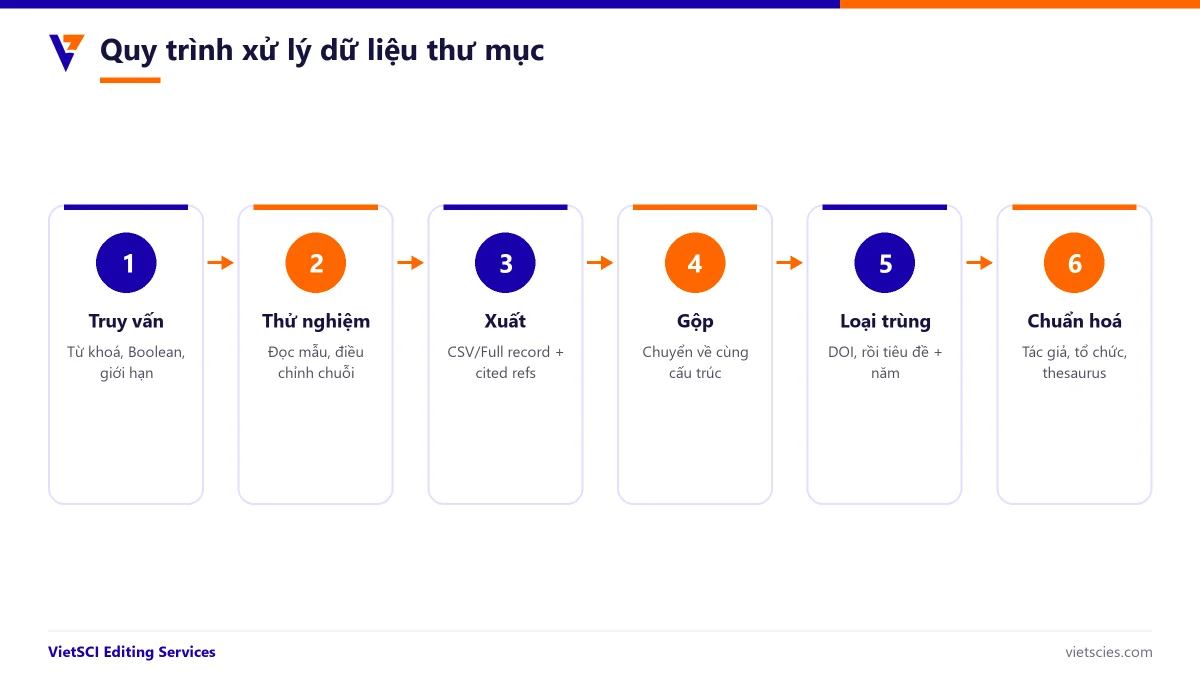
Trên Scopus, chọn tất cả kết quả và xuất định dạng CSV, đánh dấu đủ các nhóm trường: thông tin trích dẫn, thông tin thư mục, tóm tắt và từ khoá, tài liệu tham khảo. Với tập dữ liệu lớn, có thể cần chia nhỏ theo năm để xuất.
Trên Web of Science, chọn xuất Plain text file hoặc Tab delimited file với nội dung Full Record and Cited References. Web of Science giới hạn số bản ghi cho mỗi lần xuất, vì vậy bạn cần xuất theo từng đợt (ví dụ bản ghi 1-1000, 1001-2000…) và kiểm tra để không bỏ sót đợt nào.
Mẹo: đặt tên tệp theo quy tắc thống nhất (nguồn_ngày_đợt), lưu ảnh chụp màn hình chuỗi truy vấn và số kết quả. Những thông tin này cần cho sơ đồ PRISMA và để trả lời phản biện.
Gộp nguồn và loại bản ghi trùng
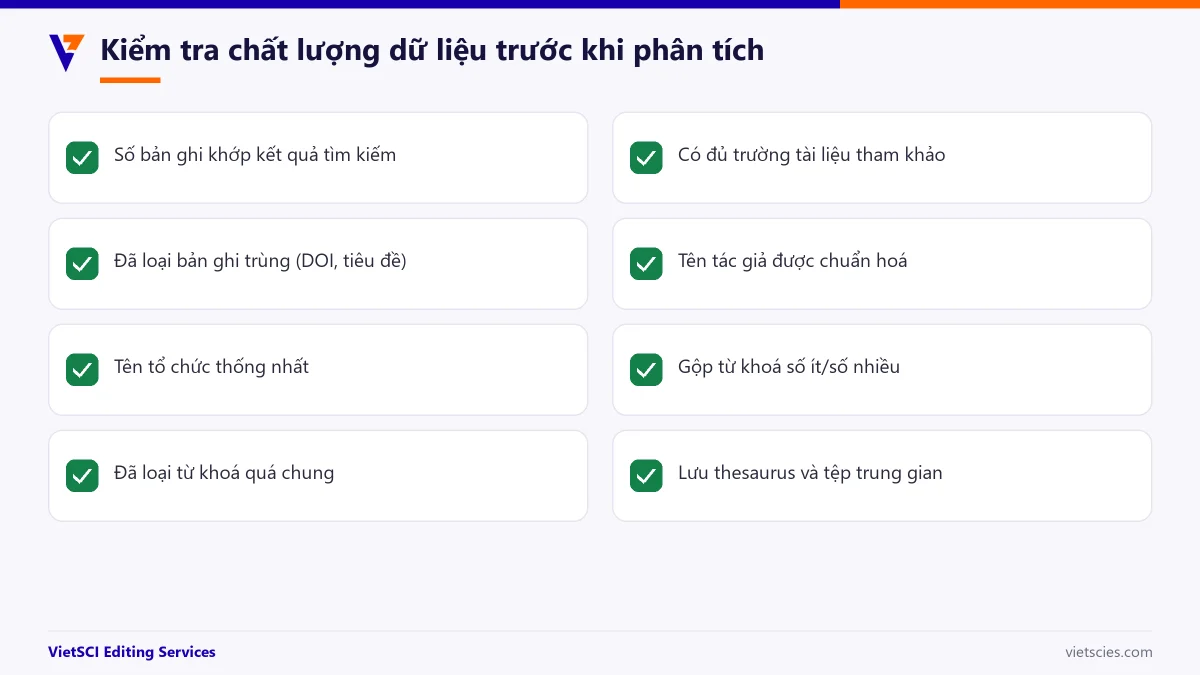
Khi dùng cả hai cơ sở dữ liệu, một bài báo có thể xuất hiện hai lần với định dạng trường khác nhau. Gói Bibliometrix trên R hỗ trợ chuyển đổi tệp về cùng cấu trúc và gộp các nguồn, có tuỳ chọn loại trùng. Nguyên tắc loại trùng hiệu quả là so khớp theo DOI trước, sau đó so khớp tiêu đề đã chuẩn hoá (bỏ dấu câu, chữ hoa) kết hợp năm xuất bản cho các bản ghi không có DOI.
Lưu ý: khi gộp nguồn, một số phân tích dựa trên trích dẫn có thể bị ảnh hưởng do mỗi cơ sở dữ liệu định dạng tài liệu tham khảo khác nhau. Hãy kiểm tra kết quả và nêu rõ hạn chế này.
Chuẩn hoá tác giả, tổ chức và từ khoá
Đây là bước tốn thời gian nhất nhưng ảnh hưởng lớn nhất đến kết quả:
- Tên tác giả: cùng một người có thể xuất hiện dưới nhiều dạng; tên tác giả Việt Nam đặc biệt dễ bị đảo thứ tự họ - tên. Dùng mã định danh tác giả (Scopus Author ID, ORCID) khi có thể.
- Tổ chức: tên trường, viện có nhiều cách viết, tên viết tắt và tên cũ - mới sau sáp nhập.
- Từ khoá: gộp số ít - số nhiều, viết tắt - đầy đủ, chính tả Anh - Mỹ; loại các từ quá chung chung.
Các quy tắc chuẩn hoá nên được lưu trong tệp thesaurus để áp dụng nhất quán và có thể tái lập.
Điều khoản sử dụng dữ liệu
Dữ liệu từ Scopus và Web of Science được cung cấp theo hợp đồng thuê bao của tổ chức bạn và chịu điều khoản sử dụng của nhà cung cấp. Nhìn chung, bạn được dùng dữ liệu cho mục đích nghiên cứu, nhưng cần thận trọng khi chia sẻ công khai toàn bộ dữ liệu thô. Một giải pháp phổ biến là công bố chuỗi truy vấn, ngày truy xuất và danh sách mã định danh (DOI) để người khác có thể tự tái lập.
Kết luận
Dữ liệu sạch là nền móng của mọi bản đồ khoa học đáng tin cậy. Hãy dành đủ thời gian cho chuỗi truy vấn, xuất dữ liệu và chuẩn hoá. Nếu cần hỗ trợ, dịch vụ phân tích trắc lượng thư mục của VietSCI thực hiện toàn bộ quy trình kỹ thuật dựa trên quyền truy cập hợp pháp của bạn và bàn giao tệp làm sạch, thesaurus để kết quả có thể kiểm chứng.