Xử lý số liệu SPSS là bước biến bảng dữ liệu khảo sát thành bằng chứng trả lời câu hỏi nghiên cứu. Làm đúng trình tự, bạn có kết quả nhất quán, giải thích được trước hội đồng; làm sai, bạn mất hàng tuần chạy lại và có nguy cơ kết luận lệch. Bài viết hướng dẫn 8 bước xử lý số liệu SPSS cho luận văn, bài báo khoa học, kèm ngưỡng đánh giá thường dùng và nguyên tắc trung thực với dữ liệu.
Table of Contents
Nội dung bài viết- Chuẩn bị trước khi xử lý số liệu SPSS
- Quy trình 8 bước xử lý số liệu SPSS
- Bước 1-2: Nhập liệu và làm sạch dữ liệu
- Bước 3: Thống kê mô tả
- Bước 4-5: Cronbach’s Alpha và phân tích nhân tố EFA
- Bước 6-7: Tương quan và hồi quy
- Bước 8: Trình bày kết quả xử lý số liệu SPSS
- Xử lý số liệu SPSS trung thực: ranh giới không được vượt qua
- Ví dụ xử lý số liệu SPSS cho một mô hình
- Mẹo tiết kiệm thời gian
- 7 lỗi thường gặp
- Câu hỏi thường gặp

Chuẩn bị trước khi xử lý số liệu SPSS
Trước khi mở phần mềm, hãy chắc chắn bạn có ba thứ: mô hình nghiên cứu với các giả thuyết rõ ràng, bảng mã hoá biến (codebook) và dữ liệu thật đã thu thập theo đúng phương pháp ghi trong đề cương. Nếu chưa có mô hình chặt chẽ, hãy xem lại bài đề cương nghiên cứu khoa học trước.
Bảng mã hoá liệt kê tên biến ngắn (ví dụ CDS1, CDS2 cho các câu hỏi về chuyển đổi số), nhãn đầy đủ, thang đo và cách mã hoá giá trị (1 = Hoàn toàn không đồng ý … 5 = Hoàn toàn đồng ý). Chuẩn bị kỹ bảng này giúp quá trình xử lý số liệu SPSS nhanh, ít nhầm lẫn và dễ kiểm tra lại.
Phần mềm IBM SPSS Statistics có bản dùng thử và bản quyền cho cơ sở đào tạo; bạn có thể xem thông tin chính thức tại trang IBM SPSS Statistics. Hãy dùng bản có bản quyền hợp lệ theo chính sách của trường hoặc cơ quan.
Quy trình 8 bước xử lý số liệu SPSS
- Nhập liệu và khai báo biến (Variable View).
- Làm sạch dữ liệu: giá trị ngoài thang, trả lời thiếu, phiếu không hợp lệ.
- Thống kê mô tả mẫu và biến.
- Kiểm định độ tin cậy thang đo bằng Cronbach’s Alpha.
- Phân tích nhân tố khám phá EFA.
- Phân tích tương quan Pearson.
- Hồi quy tuyến tính và kiểm tra giả định.
- Trình bày, diễn giải kết quả theo câu hỏi nghiên cứu.
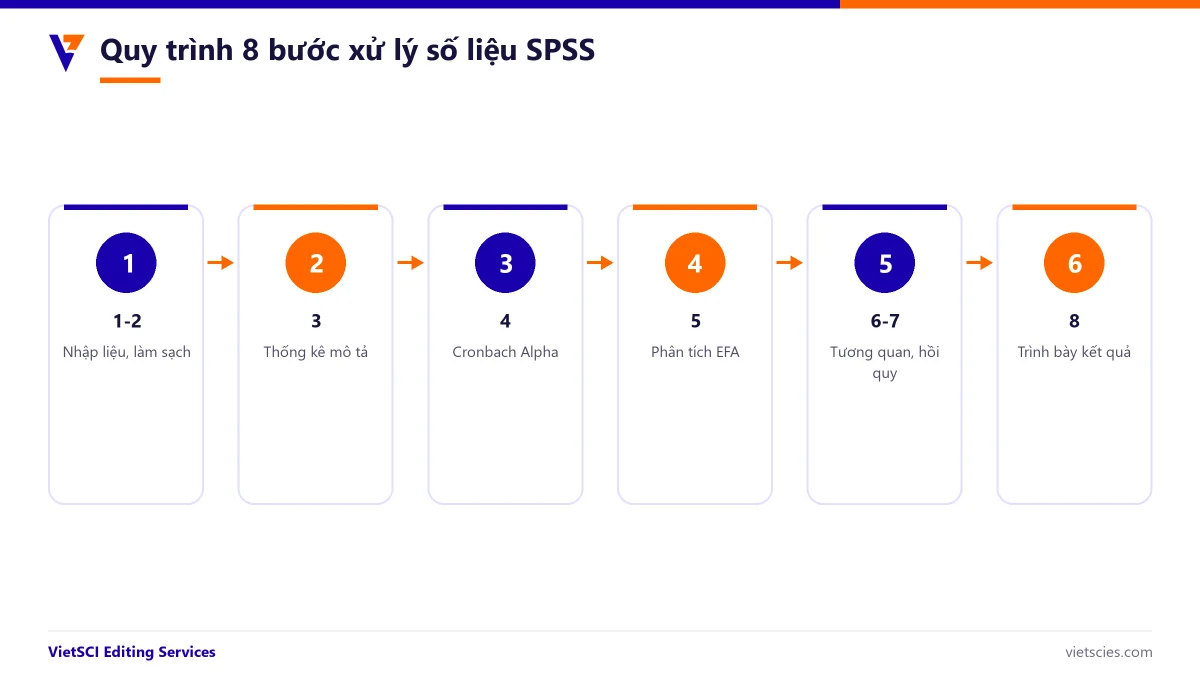
Trình tự xử lý số liệu SPSS này áp dụng cho phần lớn nghiên cứu định lượng dùng bảng hỏi Likert. Nếu mô hình của bạn có biến trung gian, biến điều tiết hoặc nhiều tầng quan hệ, có thể cần thêm CFA, SEM bằng AMOS hoặc SmartPLS sau bước EFA.
Bước 1-2: Nhập liệu và làm sạch dữ liệu
Khai báo biến
Trong Variable View, đặt tên biến không dấu, không khoảng trắng; điền Label đầy đủ; khai báo Values cho biến định danh (giới tính, ngành) và Measure đúng loại (Nominal, Ordinal, Scale). Khai báo chuẩn giúp bảng kết quả hiển thị rõ ràng khi xuất ra Word.
Làm sạch dữ liệu
Dùng Analyze → Descriptive Statistics → Frequencies để phát hiện giá trị nằm ngoài thang đo (ví dụ số 6 trong thang 5 mức) do nhập nhầm, và đối chiếu lại với phiếu gốc để sửa đúng giá trị đã ghi. Phiếu trả lời thiếu quá nhiều, chọn cùng một mức cho mọi câu hoặc vi phạm câu hỏi kiểm tra có thể loại theo tiêu chí bạn đã nêu trước trong phương pháp.
Điều quan trọng khi làm sạch là ghi lại mọi quyết định: loại bao nhiêu phiếu, vì sao, theo tiêu chí nào. Tiêu chí phải được đặt ra trước khi xem kết quả hồi quy, không phải sau khi thấy kết quả “chưa đẹp”. Đây là phần hội đồng hay hỏi nhất khi đọc chương xử lý số liệu SPSS.
Bước 3: Thống kê mô tả
Trong xử lý số liệu SPSS, thống kê mô tả trả lời câu hỏi “mẫu của bạn là ai”. Báo cáo tần số, tỷ lệ phần trăm cho biến nhân khẩu học (giới tính, độ tuổi, ngành nghề) và trung bình, độ lệch chuẩn cho các biến quan sát. Kiểm tra thêm độ lệch (Skewness) và độ nhọn (Kurtosis) để đánh giá sơ bộ phân phối chuẩn.
Đừng bỏ qua bước này: một mẫu lệch nhiều về một nhóm (ví dụ 80% là nữ hay 90% thuộc một ngành) ảnh hưởng đến khả năng khái quát kết quả, và bạn cần nêu điều đó trong phần hạn chế.
Bước 4-5: Cronbach’s Alpha và phân tích nhân tố EFA
Cronbach’s Alpha
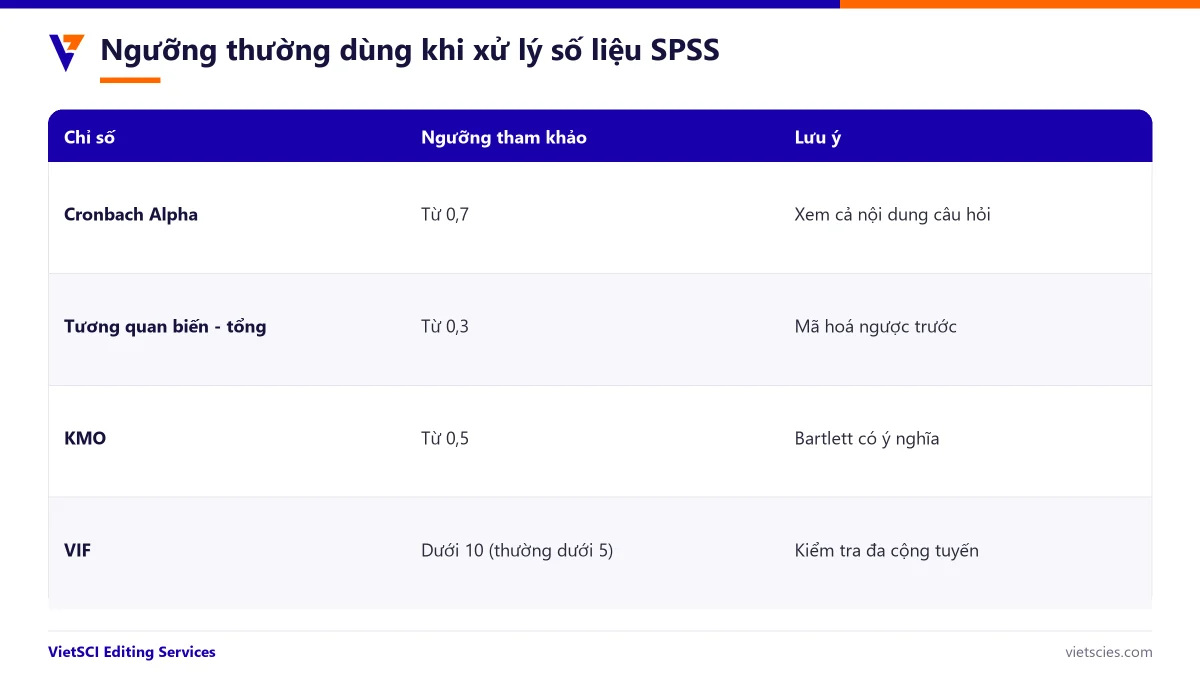
Vào Analyze → Scale → Reliability Analysis, chọn các biến quan sát của từng thang đo. Nhiều tài liệu phương pháp dùng ngưỡng Cronbach’s Alpha từ 0,7 trở lên cho thang đo đã kiểm định và hệ số tương quan biến - tổng từ 0,3 trở lên. Khi loại biến, cân nhắc cả ý nghĩa nội dung chứ không chỉ con số, và luôn trích dẫn nguồn cho ngưỡng bạn áp dụng.
Phân tích nhân tố khám phá EFA
Analyze → Dimension Reduction → Factor. Các chỉ số thường báo cáo: KMO (thường từ 0,5 trở lên), kiểm định Bartlett có ý nghĩa thống kê, tổng phương sai trích, hệ số tải nhân tố (factor loading) và cách xoay (Varimax hoặc Promax). Kết quả EFA cho biết các biến quan sát có nhóm lại đúng như thang đo lý thuyết hay không.
Nếu một biến tải lên hai nhân tố với hệ số gần bằng nhau hoặc tải thấp, hãy xem lại nội dung câu hỏi, cách dịch và đối tượng trả lời trước khi quyết định loại. Mọi biến bị loại phải được báo cáo trong bài, kèm lý do.
Bước 6-7: Tương quan và hồi quy
Phân tích tương quan
Tạo biến đại diện (thường là trung bình các biến quan sát của nhân tố), sau đó chạy Analyze → Correlate → Bivariate. Tương quan Pearson giữa biến độc lập và biến phụ thuộc cho cái nhìn ban đầu về mối quan hệ; tương quan quá cao giữa các biến độc lập là dấu hiệu cần chú ý đa cộng tuyến.
Hồi quy tuyến tính
Analyze → Regression → Linear. Báo cáo R² hiệu chỉnh, kiểm định F, hệ số hồi quy chuẩn hoá (Beta), giá trị sig. và VIF. Kiểm tra các giả định: phần dư phân phối xấp xỉ chuẩn (biểu đồ Histogram, P-P plot), phương sai đồng nhất (biểu đồ Scatter), không tự tương quan (Durbin-Watson) và không đa cộng tuyến nghiêm trọng.
Khi xử lý số liệu SPSS, kết luận giả thuyết phải dựa đúng trên kết quả: giả thuyết bị bác bỏ vẫn là phát hiện có giá trị và cần được thảo luận trung thực, đối chiếu với nghiên cứu trước.
Bước 8: Trình bày kết quả xử lý số liệu SPSS
Kết quả xử lý số liệu SPSS nên được trình bày theo câu hỏi nghiên cứu, không theo thứ tự lệnh đã chạy. Mỗi bảng có tiêu đề, đơn vị, ghi chú nguồn và chỉ giữ các chỉ số cần thiết - tránh dán nguyên bảng output dài nhiều trang vào chương kết quả.
- Định dạng bảng theo chuẩn trích dẫn của trường hoặc tạp chí (APA, IEEE…), làm tròn nhất quán 2-3 chữ số thập phân.
- Văn bản diễn giải ý nghĩa, không lặp lại toàn bộ con số đã có trong bảng.
- Lưu tệp dữ liệu gốc, tệp cú pháp (Syntax) và tệp output để có thể chạy lại, chứng minh tính minh bạch khi được yêu cầu.
Mẹo nhỏ: dùng Paste để lưu cú pháp của từng lệnh thay vì chỉ bấm OK. Tệp cú pháp là “nhật ký” của toàn bộ quá trình xử lý số liệu SPSS, giúp bạn và giảng viên hướng dẫn kiểm tra lại từng bước.
Xử lý số liệu SPSS trung thực: ranh giới không được vượt qua
Áp lực “kết quả phải có ý nghĩa” khiến không ít người bị cám dỗ chỉnh dữ liệu. Đây là vi phạm nghiêm trọng liêm chính khoa học, có thể dẫn đến huỷ kết quả bảo vệ, thu hồi bằng hoặc rút bài đã đăng.
- Không bịa dữ liệu: không tạo phiếu khảo sát không có thật, không nhân bản phiếu để tăng cỡ mẫu.
- Không làm giả dữ liệu: không sửa câu trả lời để Cronbach’s Alpha hay hệ số hồi quy “đẹp” hơn.
- Không lựa chọn kết quả có lợi (p-hacking): không chạy hàng chục mô hình rồi chỉ báo cáo mô hình có ý nghĩa; không loại phiếu sau khi xem kết quả.
- Báo cáo đầy đủ: nêu cỡ mẫu ban đầu, số phiếu loại, biến bị loại và lý do.
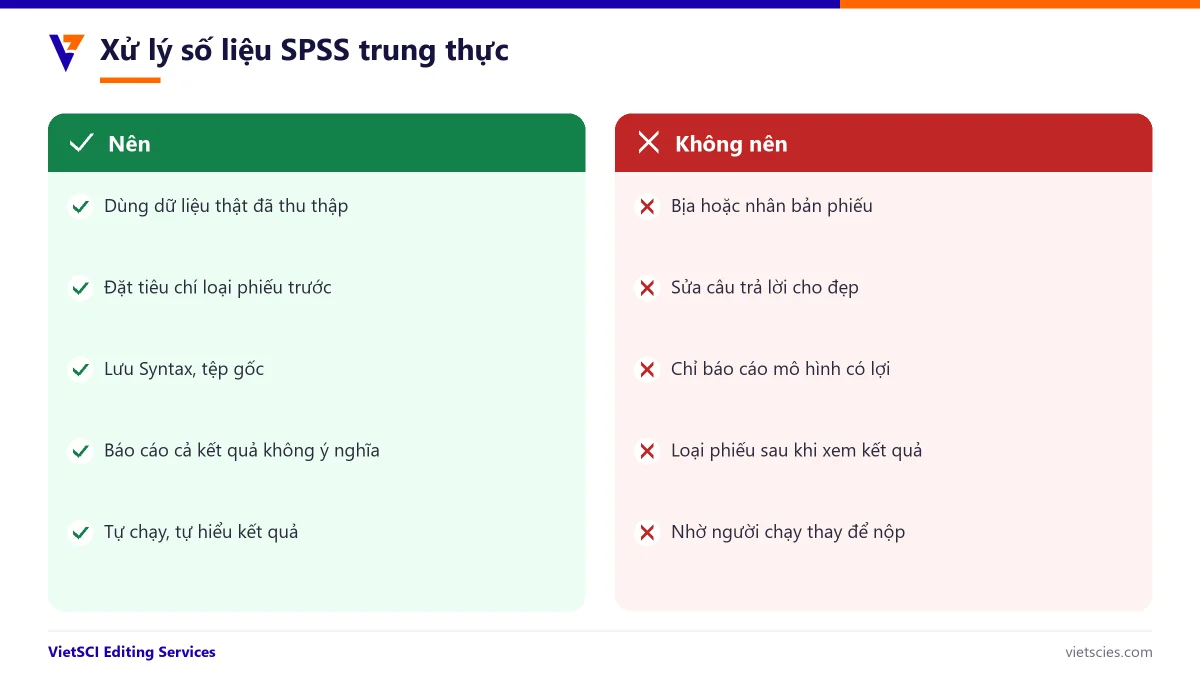
Một chuyên gia hướng dẫn đúng nghĩa sẽ giúp bạn hiểu vì sao kết quả như vậy và cách diễn giải hợp lý, chứ không “chạy số liệu thay” hay chỉnh dữ liệu cho bạn. Tham khảo thêm Cam kết liêm chính khoa học và nguyên tắc của COPE về đạo đức công bố.
Ví dụ xử lý số liệu SPSS cho một mô hình
Giả sử đề tài của bạn kiểm định tác động của bốn nhân tố (hạ tầng số, năng lực số, ứng dụng số trong bán hàng, văn hoá số) đến hiệu quả hoạt động của doanh nghiệp, với 300 phiếu khảo sát hợp lệ. Quá trình xử lý số liệu SPSS điển hình diễn ra như sau.
- Làm sạch: thu về 320 phiếu, loại 20 phiếu trả lời thiếu trên 10% câu hỏi hoặc chọn cùng một mức cho mọi câu - tiêu chí đã ghi sẵn trong đề cương.
- Mô tả mẫu: báo cáo cơ cấu theo ngành, quy mô lao động, số năm hoạt động; nêu rõ nhóm nào chiếm tỷ trọng lớn.
- Độ tin cậy: chạy Cronbach’s Alpha cho từng thang đo; một biến có tương quan biến - tổng thấp được xem lại nội dung và được loại kèm giải thích.
- EFA: chạy chung các biến độc lập; kiểm tra KMO, Bartlett, phương sai trích và ma trận xoay để xác nhận bốn nhóm nhân tố.
- Tương quan và hồi quy: tạo biến đại diện, chạy tương quan Pearson, sau đó hồi quy với bốn biến độc lập; kiểm tra VIF, Durbin-Watson và biểu đồ phần dư.
- Kết luận: chấp nhận hoặc bác bỏ từng giả thuyết theo đúng kết quả, so sánh với các nghiên cứu trước và nêu hàm ý quản trị.
Khi trình bày ví dụ như trên trong luận văn, hãy kể lại đúng trình tự bạn đã làm và các quyết định đã đưa ra. Hội đồng đánh giá cao một chương xử lý số liệu SPSS minh bạch hơn là một chương có toàn kết quả “đẹp” nhưng không giải thích được cách đi đến kết quả đó.
Nếu một giả thuyết không được ủng hộ, đừng vội cho rằng nghiên cứu thất bại. Có thể bối cảnh địa phương khác với các nghiên cứu nước ngoài, có thể thang đo chưa phù hợp hoặc mẫu chưa đủ đa dạng. Phân tích các khả năng này một cách thẳng thắn chính là đóng góp của bạn.
Mẹo tiết kiệm thời gian khi xử lý số liệu SPSS
- Dùng Syntax: lưu và chạy lại cú pháp giúp bạn cập nhật toàn bộ kết quả chỉ trong vài phút khi bổ sung dữ liệu.
- Tạo biến bằng Compute: đặt tên thống nhất cho biến đại diện (ví dụ CDS_TB) để không nhầm với biến quan sát.
- Xuất bảng ra Word có định dạng: dùng Export hoặc sao chép đặc biệt để giữ bảng gọn, sau đó chỉnh theo chuẩn trình bày của trường.
- Đặt tên tệp có ngày: lưu dữ liệu gốc riêng, mọi thao tác làm trên bản sao có ghi ngày tháng; không bao giờ ghi đè lên tệp gốc.
- Ghi nhật ký quyết định: một trang ghi chú về các phiếu đã loại, biến đã loại và lý do sẽ giúp bạn trả lời hội đồng nhanh chóng.
Những thói quen nhỏ này làm cho việc xử lý số liệu SPSS trở nên có hệ thống, dễ kiểm tra và giảm đáng kể thời gian sửa chữa ở giai đoạn cuối.
7 lỗi thường gặp khi xử lý số liệu SPSS
- Không làm sạch dữ liệu, để lọt giá trị ngoài thang đo.
- Quên mã hoá ngược các câu hỏi đảo chiều trước khi tính Cronbach’s Alpha.
- Loại biến chỉ dựa vào con số, không xem xét nội dung.
- Chạy hồi quy trên từng biến quan sát thay vì biến đại diện của nhân tố.
- Bỏ qua kiểm tra giả định hồi quy.
- Diễn giải “tương quan” thành “nhân quả” khi thiết kế là khảo sát cắt ngang.
- Không lưu cú pháp, không thể chạy lại khi hội đồng yêu cầu.
Nếu bạn đang làm luận văn và muốn có người giải thích từng bước trên chính dữ liệu của mình, lộ trình mentor luận văn thạc sĩ hoặc dịch vụ Mentor Xử lý định lượng của VietSCI là lựa chọn phù hợp: bạn tự chạy, tự diễn giải; Mentor hướng dẫn, góp ý và ghi nhật ký từng buổi.
Câu hỏi thường gặp về xử lý số liệu SPSS
Xử lý số liệu SPSS cần cỡ mẫu tối thiểu bao nhiêu?
Tuỳ kỹ thuật. Với EFA, nhiều tài liệu khuyến nghị tối thiểu gấp 5 lần số biến quan sát; với hồi quy, cỡ mẫu tăng theo số biến độc lập. Hãy trích dẫn nguồn quy tắc bạn dùng trong phần phương pháp.
Cronbach’s Alpha thấp phải làm sao?
Kiểm tra mã hoá ngược, nội dung câu hỏi và cách dịch. Không sửa dữ liệu để tăng hệ số; nếu thang đo thực sự kém tin cậy, hãy báo cáo trung thực và thảo luận trong phần hạn chế.
Khi nào dùng SPSS, khi nào dùng SmartPLS hay AMOS?
SPSS phù hợp cho thống kê mô tả, độ tin cậy, EFA, tương quan và hồi quy. Khi mô hình có nhiều quan hệ đồng thời, biến trung gian hoặc cần kiểm định thang đo bằng CFA, bạn dùng AMOS (CB-SEM) hoặc SmartPLS (PLS-SEM).
Có nên nhờ người khác chạy số liệu không?
Bạn có thể nhờ người hướng dẫn cách làm, nhưng không nên để người khác chạy thay rồi nộp như kết quả của mình. Bạn phải hiểu và giải thích được từng con số trước hội đồng.
Muốn tự tin xử lý số liệu SPSS trên dữ liệu của chính bạn? Đặt Mentor Xử lý định lượng: hướng dẫn 1:1 qua chia sẻ màn hình, bạn tự thao tác, Mentor giải thích và góp ý.
Cần hỗ trợ hoàn thiện bản thảo?
Nhận báo giá trực tuyến trong vài phút hoặc trao đổi với chuyên viên qua Phone/Zalo/WhatsApp 0916 086 008.